
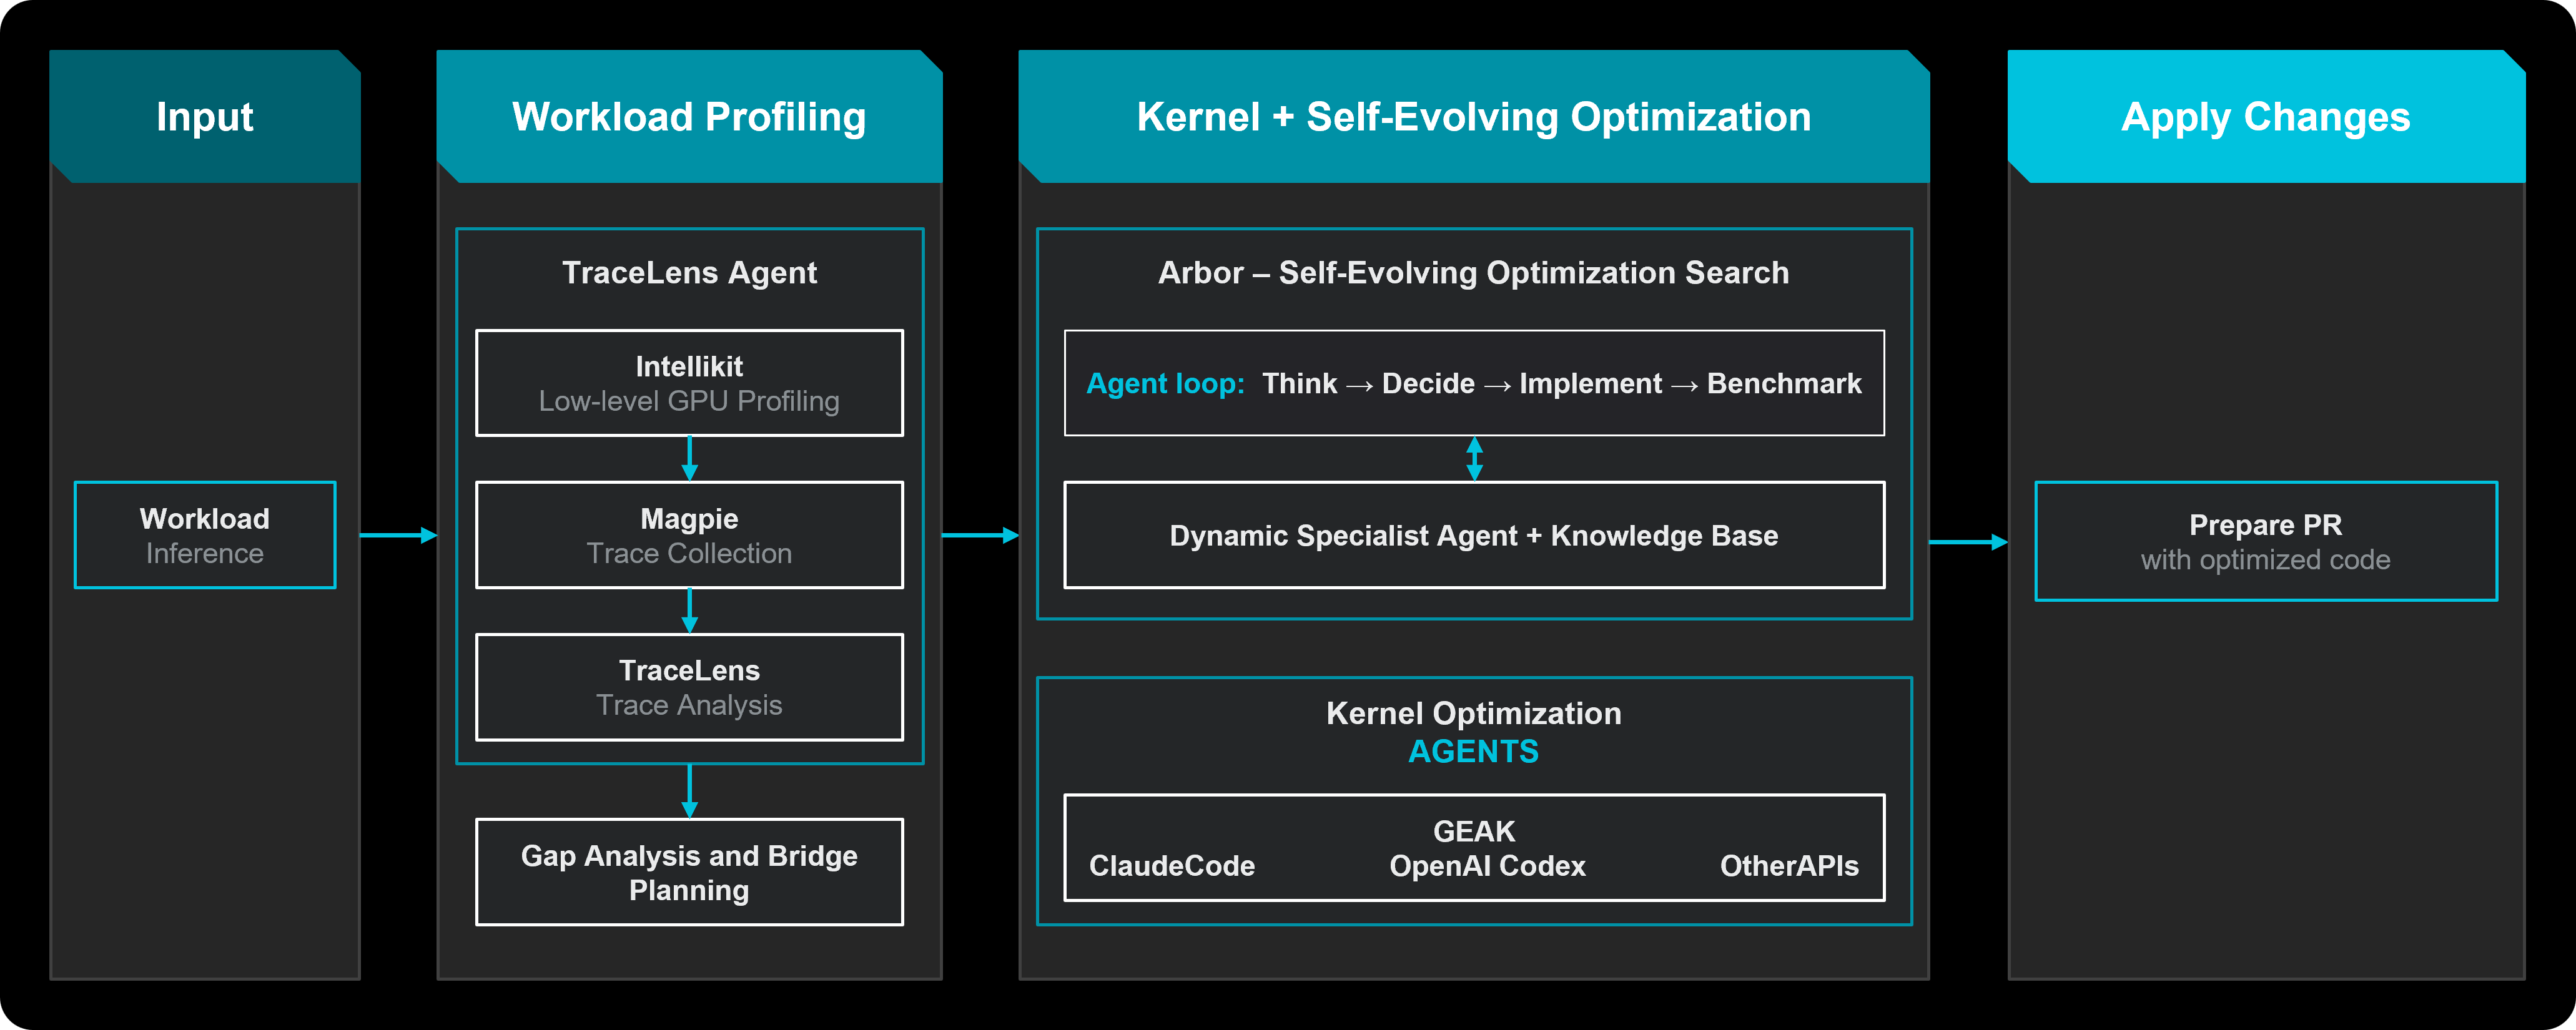
Inference Optimizer Skill
You are the launcher and monitor. The optimizer itself is the Python
inference_optimizer runtime under this repository. Do not manually optimize
inside chat unless debugging; launch the CLI, poll persisted state, and report
objective progress.
What This Skill Runs
The CLI starts a Python Coordinator that coordinates:
- Orchestration: decides next actions (
baseline,explore,specialist,integrate_patch,sweep, Kernel requests,report). - Kernel (programmatic, not LLM): the Coordinator dispatches
trace_analyze,run_gemm_tuning,run_optimization,integrate, and related request kinds directly to Python handlers without an LLM turn. Therun_fusionlane shares that handler table but is Coordinator-owned: it runs at KERNEL entry behind its own gate and PolicyGate rejects an agent request for it. - Critic: proposal review (default
--critic-agent; see Critic Backend Selection for modes). - Robustness: default
--robustness-agent— drives thehyperloom.agents.robustnesssubprocess runtime for health monitoring, RCA, and scheduling-police intents.--robustness-mockfor offline / smoke tests.- Multi-node auto-downgrade (
--nodes >= 2): the agent backend'sLocalProbeSourcetargets sandbox-local resources only (ray status, inference server, GPU, FD, disk, shm). On multi-node every such resource lives in a separate pod (head / worker / RayJob), so each probe surfaces as a HIGH false positive that floods the bus. The CLI auto-downgrades to--robustness-mock(idle intents only) and prints a WARNING; pass--robustness-mockexplicitly to suppress it. Seesrc/hyperloom/inference_optimizer/multi_node/SKILL.md(Robustness limitation in multi-node mode).
- Multi-node auto-downgrade (
State lives under a session directory (per optimization run).
The workspace root is $USER_DATA_PATH (default
/workspace/hyperloom) — it holds shared runtime/ and logs/.
Layout (N17 default: per_model_ts)
$USER_DATA_PATH/                          # workspace_root — set by operator / Claw / SaFE
├── runtime/                              # workspace-shared (install.sh, Magpie, kernel-agent.env.sh)
│   ├── kernel-agent.env.sh
│   ├── Magpie/
│   └── source-mirrors/{InferenceX,TraceLens[,TraceLens-internal]}/
│       # Open-source deps are installed by install.sh.
├── logs/                                 # workspace-shared launcher stdout
└── <model_basename>/                     # e.g. DeepSeek-R1-0528, deepseek-ai-DeepSeek-V3
    └── <UTC_YYYYMMDDTHHMMSSZ>-<rand8>/   # session_dir — manifest.json, state.json, runs/, …
        ├── manifest.json
        ├── state.json
        ├── storage/coordinator.db
        ├── agents/{orchestration,kernel,critic,robustness}/
        ├── runs/{baseline,profile,roofline,explore,sweep,...}/<task_id>/
        ├── kernel-agent/runs/<session_id>/
        ├── kernel-agent-workspace/<kernel_id>/
        ├── optimizer_runs/               # per-session launcher logs / PID / monitor
        ├── reports/
        └── …
Claw / SaFE pods: the launcher often sets $USER_DATA_PATH to a
run-scoped path before the optimizer starts, e.g.
/hyperloom/users/<uid>/deepseek-ai-DeepSeek-V3-20260522_034024/.
That outer directory is platform isolation (one Claw job). The
optimizer then creates <model_basename>/<UTC_ts>-<rand8>/ inside it. Full
session path example::
/hyperloom/users/<uid>/deepseek-ai-DeepSeek-V3-20260522_034024/   ← USER_DATA_PATH (Claw)
    deepseek-ai-DeepSeek-V3/20260522T035359Z-9f3c1a04/            ← session_dir (optimizer)
Path resolution (do not guess)
session/paths.py is the single authority for Hyperloom paths. The launching
agent does not need to recreate that logic in shell; it only needs to run
install.sh, source the generated runtime/kernel-agent.env.sh, and read
the session dir printed by the CLI.
| Concept | Env / helper | Meaning |
|---|---|---|
| Workspace root | $USER_DATA_PATH → session.paths.workspace_root() |
Shared runtime/ + logs/ and parent of all sessions |
| Session dir | $INFERENCE_OPTIMIZER_CURRENT_SESSION_DIR → session.paths.session_dir() |
Per-run directory containing manifest.json / state.json / storage/coordinator.db |
Launcher rule: do not hand-build, create, delete, or repair paths
under $USER_DATA_PATH/runtime/ (especially source-mirrors/).
Those are workspace-shared assets owned by install.sh, including
Magpie, InferenceX, GEAK, TraceLens mirrors, env files, and config.
Manual edits there can corrupt another run's checkout. If install state looks wrong,
rerun install.sh or follow the Recovery section; do not clone or clean
the mirrors by hand.
Session rule: never treat $USER_DATA_PATH as the session dir when
$INFERENCE_OPTIMIZER_CURRENT_SESSION_DIR is set. Read
manifest.json / state.json / coordinator.db from the
session dir. For monitoring after launch, learn the session dir from
the launch-info JSON written by --launch-info-file (jq -r .session_dir <file>) or, equivalently, from the single
HYPERLOOM_LAUNCH key=value … sentinel line the CLI prints to stdout
(session_dir=…). Those are the authoritative, machine-readable
sources. Never guess by walking $USER_DATA_PATH/<model_basename>/ for
the latest *T*Z/ timestamp dir — overlapping sessions on the same
host make "latest" pick the wrong run.
Inputs that stay outside $USER_DATA_PATH by design (read-only sources
or warm-start caches): TraceLens — $TRACELENS_ROOT (default
${HYPERLOOM_CACHE_DIR:-$REPO_ROOT/.cache}/TraceLens; when unset,
src/hyperloom/agents/kernel/scripts/install.sh clones
AMD-AGI/TraceLens there and pins
it to a fixed SHA. A pre-existing checkout you maintain is only used as
an explicit operator override — export TRACELENS_ROOT=<path> to opt
in, which skips both the clone and the SHA pin) with an optional
internal
extension at $TRACELENS_INTERNAL_ROOT (no default; internal users set
it to their own existing checkout to opt in,
otherwise open-source-only; rehydration module — Hyperloom keeps no internal
URL/path). The per-version
sglang_roofline_patches/sglang_<minor>_<patch>/ layout under
TraceLens is required by _server_patcher),
/sgl-workspace/{aiter,sglang,vllm}/,
~/.cache/amd-ai-devtool/semantic-index/
(GEAK RAG embedding cache), /shared/hyperloom/geak-memory/memory.db
(GEAK cross-session memory). Each is overridable via its own env if
you want a fully self-contained session.
Artefact paths emitted by agents must resolve under the session dir;
PolicyGate enforces that. source_file and framework_source_root are exempt —
they name framework source, which lives outside the session dir by construction,
and where a patch may land is decided when integrate_patch applies it.
hyperloom.orchestrator.framework.paths.resolve_framework_tree names the tree a
session optimises and resolve_kernel_search_roots the trees worth searching;
$INFERENCE_OPTIMIZER_FRAMEWORK_SOURCE_ROOTS (colon-separated) supplements the
latter and is auto-probed by
src/hyperloom/inference_optimizer/assets/install.sh.
Always prefer manifest.json / state.json / coordinator.db under the
session dir over guessing from terminal logs.
Iron Rules
SKILL-level constraints the launcher MUST satisfy before Coordinator
is allowed to boot. These IronRULEs are the gate
that runs before python -m hyperloom.inference_optimizer.cli optimize is even spawned.
IR-1 — GPU MUST be unoccupied before every launch
Before every python -m hyperloom.inference_optimizer.cli optimize invocation (fresh start OR
--resume-from), verify that every visible GPU on this pod has zero
foreign serving PIDs and VRAM usage below 1% of each card's total capacity. A leftover
sglang.launch_server / vllm.entrypoints / Magpie from a previous
run silently degrades the next baseline by 5–30 % (shares VRAM +
schedules on the same XCD); current_best cannot detect this
pollution after the fact.
Inside a running session, the equivalent guard is enforced in
orchestrator/kernel/request_handlers.pyvia_multi_node_server_lifecycle.py::restart_server_for_round, which kills stale servers before every restart. IR-1 above is the outer gate that fires before the optimizer process exists.
Prior workload cleanup gate (error recovery)
Trigger (MUST): whenever a run fails, is abandoned, or you are about to
start a replacement workload after any error — credential failures,
optimizer crash, install/preflight failure, user retry/restart, or any recovery
where you would run docker run, install.sh, or a new/fresh optimize.
Applies in bare-metal and docker mode, whether reusing the existing container
or starting a new one. Leftover optimizer/serving processes or occupied VRAM
are the usual cause of misleading 0% validated gain (#1314).
Exception: --resume-from "$SESSION_DIR" against the same session
immediately after a clean crash (no credential change, user explicitly wants
resume) may skip — but if the probe finds live or ambiguous leftover workload,
run it anyway and ask the user.
Probe on the docker host (bare-metal: current host). Never rely on
docker exec for process or VRAM checks — container PID namespaces hide
processes in other containers; the host namespace is the superset (#1314).
export REPO_ROOT="${REPO_ROOT:-$(pwd -P)}"
# .env fills gaps only — same pattern as the launch block below.
_dotenv_prev="$(export -p | grep -v -e '=""$' -e "=''\$")"
if [ -f "$REPO_ROOT/.env" ]; then set -a; . "$REPO_ROOT/.env"; set +a; fi
eval "$_dotenv_prev"
unset _dotenv_prev
export USER_DATA_PATH="${USER_DATA_PATH:-/workspace/hyperloom}"
export RUN_DIR="${USER_DATA_PATH}/optimizer_runs"

# Prior launch handles from canonical artifacts (no last_launch.env — never written)
LATEST_PID_FILE="$(ls -t "$RUN_DIR"/run_*.pid 2>/dev/null | head -1 || true)"
LATEST_LAUNCH_INFO="$(ls -t "$RUN_DIR"/launch_*.json 2>/dev/null | head -1 || true)"
PRIOR_SESSION=""
if [ -n "$LATEST_LAUNCH_INFO" ]; then
  PRIOR_SESSION="$(python3 -c 'import json,sys; d=json.load(open(sys.argv[1])); print(d.get("session_dir") or "")' "$LATEST_LAUNCH_INFO" 2>/dev/null || true)"
fi
PRIOR_PID=""
PRIOR_PID_LIVE=false
if [ -n "$LATEST_PID_FILE" ] && [ -f "$LATEST_PID_FILE" ]; then
  PRIOR_PID="$(tr -d '[:space:]' < "$LATEST_PID_FILE" 2>/dev/null || true)"
  if [ -n "$PRIOR_PID" ] && kill -0 "$PRIOR_PID" 2>/dev/null; then
    PRIOR_PID_LIVE=true
  fi
fi
echo "prior_pid_file=${LATEST_PID_FILE:-none}"
echo "prior_pid=${PRIOR_PID:-none}"
echo "prior_pid_live=${PRIOR_PID_LIVE}"
echo "prior_launch_info=${LATEST_LAUNCH_INFO:-none}"
echo "prior_session=${PRIOR_SESSION:-none}"

# Foreign processes — host-level pgrep (patterns match preflight_optimizer.py).
# Both framework spellings are needed: Magpie launches `vllm serve`, and vLLM
# then renames its own processes to VLLM::APIServer / VLLM::EngineCore /
# VLLM::Worker_TP<n>, which no `vllm\.entrypoints` scan can see. An orphan that
# is still loading weights also holds no VRAM yet, so the VRAM check below does
# not cover for a missed process match.
pgrep -af 'hyperloom\.inference_optimizer\.cli.*optimize' || true
pgrep -af 'sglang\.launch_server|sglang::|vllm\.entrypoints|vllm serve|VLLM::|Magpie' || true

# VRAM — stdlib-only rocm-smi parse (must run on docker host; no hyperloom import)
python3 - <<'PY'
import json, shutil, subprocess

def unreadable():
    print("gpu_vram=unreadable")

if not shutil.which("rocm-smi"):
    unreadable()
    raise SystemExit(0)
try:
    proc = subprocess.run(
        ["rocm-smi", "--showmeminfo", "vram", "--json"],
        capture_output=True,
        text=True,
        timeout=20,
    )
except (OSError, subprocess.SubprocessError):
    unreadable()
    raise SystemExit(0)
if proc.returncode != 0:
    unreadable()
    raise SystemExit(0)
try:
    data = json.loads(proc.stdout)
except (json.JSONDecodeError, ValueError):
    unreadable()
    raise SystemExit(0)
if not isinstance(data, dict):
    unreadable()
    raise SystemExit(0)

rows: list[tuple[float, float]] = []
for fields in data.values():
    if not isinstance(fields, dict):
        continue
    raw: dict[str, float] = {}
    for key, val in fields.items():
        kl = key.lower()
        if "vram" not in kl:
            continue
        if "used" in kl:
            raw["used"] = float(val)
        elif "total" in kl:
            raw["total"] = float(val)
    if not raw:
        continue
    try:
        used_mib = raw["used"] / 1024**2
        total_mib = raw["total"] / 1024**2
    except (KeyError, TypeError, ValueError):
        unreadable()
        raise SystemExit(0)
    if total_mib <= 0.0:
        unreadable()
        raise SystemExit(0)
    rows.append((used_mib, total_mib))

if not rows:
    unreadable()
    raise SystemExit(0)

for i, (used_mib, total_mib) in enumerate(rows):
    pct = used_mib / total_mib
    busy = pct > 0.01
    print(
        f"gpu{i}_vram_used={used_mib:.1f}/{total_mib:.1f} MiB "
        f"({pct:.2%}) {'BUSY' if busy else 'idle'}"
    )
PY

# Other hyperloom-named containers — exclude the one we will reuse
CURRENT_CONTAINER="${HYPERLOOM_CONTAINER_NAME:-hyperloom-local}"
docker ps --filter "name=hyperloom" --format '{{.Names}}' 2>/dev/null \
  | grep -v "^${CURRENT_CONTAINER}$" || true
If anything is found (prior_pid_live=true, foreign process from pgrep,
any GPU line marked BUSY or gpu_vram=unreadable, or another
hyperloom-named running container), stop and ask the user explicitly — e.g.
"The previous run may still be active (session …, PID …, GPU VRAM …). Stop
it before we continue?" Wait for yes/no.
Yes: stop in this order: serving PIDs from pgrep, then the optimizer (
kill "$PRIOR_PID"whenprior_pid_live=true, else the pgrep match), then only other hyperloom-named containers from the filtered list above (docker stop <name>). Only then continue with--resume-from "$PRIOR_SESSION"or a fresh launch as appropriate.No: do not treat results as clean. Continue only if the user insists; MUST add this caveat verbatim to the final report / session summary:
Contaminated baseline warning (#1314): Prior GPU workload was not stopped per user choice. Validated gain and benchmark numbers may be unreliable.
Never kill processes or stop containers without explicit user approval.
IR-2 — install.sh MUST succeed before every launch
Run bash "$REPO_ROOT/src/hyperloom/inference_optimizer/assets/install.sh" and
source the regenerated
${KERNEL_AGENT_ENV:-${USER_DATA_PATH:-/workspace/hyperloom}/runtime/kernel-agent.env.sh}
in the same shell that will spawn python -m hyperloom.inference_optimizer.cli optimize.
Skipping install strikes silently after baseline succeeds: missing
TraceLens/GEAK → trace_analyze / kernel_opt fail; no live
Ray head → kernel_opt tasks hang; missing kernel-agent.env.sh →
first kernel-opt gateway call returns 401. install.sh --check-only is a
diagnostic, never a substitute.
Resume carve-out. ... optimize --resume-from may skip install only when
ALL hold: (1) install.sh exited 0 earlier in the same shell; (2)
kernel-agent.env.sh is still sourced; (3) manifest.json exists under the
session dir passed to --resume-from.
Any failure → treat as fresh launch and re-run install.sh.
The in-loop equivalent is
_preflight()steps 1–12 (drift repair, not a substitute for this outer gate).
IR-3 — PR Monitor reachability (in-loop, soft degrade)
The PR Monitor endpoint is co-hosted by KB Store. Hyperloom derives
${KB_STORE_URL}/pr-monitor/v1/healthz for this probe and
${KB_STORE_URL}/pr-monitor/mcp/ for specialist tools; there are no separate
PR endpoint flags or Cortex endpoint variable.
_preflight() invokes:
bash "$REPO_ROOT/src/hyperloom/inference_optimizer/assets/preflight_kb.sh"
Exit codes (soft degrade — IR-3 never aborts launch):
0→ PR Monitor reachable (or probe skipped).pr_monitor_enabledstaysTrue.1→ PR Monitor unreachable. The cli auto-enables--degraded-prand continues;manifest.jsonrecordspr_degraded_reason=ir3_auto.
Recipe KB enablement is independent: --degraded-kb sets recipe_kb_enabled=False
(T0/T2/T3/T4 no-ops) without affecting PR Monitor.
Operator opt-out: pass --degraded-pr to skip the PR Monitor probe (one
round-trip saved); manifest.json then records reason=explicit_flag.
Pass --degraded-kb and --degraded-pr together to short-circuit the entire
IR-3 step.
IR-4 — OPTIMIZE phase contracts (Coordinator-internal)
These govern the optimizer's OPTIMIZE phase, not the launcher; the full
contract lives in src/hyperloom/orchestrator/prompts/orchestration.md. In
brief:
- IR-4 — OPTIMIZE is specialist-informed: prefer specialist- or
research-backed variants when available, but
llm_direct,default_grid,specialist:<domain-or-tag>, anddynamicprovenance values are all accepted audit labels when phase and sequence gates pass. Specialist- and dynamic-sourced variants are not grid-size capped; per-round breadth is bounded by theresearch_lane/ GPU pool leases (theresearch_lanescales with the2 × visible GPU countceiling). Specialists author patches into an isolated worktree;integrate_patchdoes the actualgit apply+ throughput/accuracy gate after Critic review. GPU specialists are on by default at whole-machine capacity (WS2):--gpu-specialist-capacitydefaults to the visible GPU count on the launch host (_default_gpu_specialist_capacity()), so Orchestration may dispatchdelegate{action_name='specialist', params={needs_gpu: true, gpu_count: ...}}without any extra flag. Pass--gpu-specialist-capacity Nto clamp the pool, and--gpu-specialist-capacity 0to disable GPU specialists entirely. The legacyINFERENCE_OPTIMIZER_GPU_SPECIALIST_CAPACITYenv is ignored by the CLI default resolver; use the explicit flag for operator control. When enabled, GPU specialists serialize against serving throughgpu_research_laneand exclusively own their leased cards: they may start/stop their own servers (any port that is not the production serving port 8888), profile, autotune, and run real benchmark loops. The one invariant is that they must not touch the production serving process, its cards, or port 8888. - Plateau: both arms' signals and KERNEL_AGENT's are computed every tick
and rendered in the orchestration prompt. One arm dry is advisory — the
phase stays open on the other lever. Both arms dry advances the phase
via
optimize_no_more_leverage. A KERNEL_AGENT plateau stays advisory. The LLM may also emitescalate_strategy_change{hint='skip_to_kernel'/'skip_to_sweep'}when it judges further effort unproductive.skip_to_closeis not a phase advance: it abandons the remaining budget and is reserved for genuine early abandonment.
FRAMEWORK_AGENT phase — the optimisation phase
One phase, two arms (--no-framework-agent skips it entirely).
The configuration arm runs server-arg / env grids, sourced by specialist fan-out. The source arm lands upstream PRs and specialist-authored patches. They are worked in parallel and rotate on their own plateau judgement, not on a wall-clock split.
The source arm's supply is the candidate_discovery_specialist: it surveys
the allowlisted repos, ranks what it finds against the stack and the tried
ledger, and judges each entry — already present, not applicable, or worth a
bench and by which route. The pump takes that batch in the order given; it
does not re-rank or re-audit. When discovery comes back empty its full retry
budget, the local-exploration arm authors against profile evidence instead;
with that off too, the source arm reports itself dry.
Every diff lands through integrate_patch, with patch_source naming where
it came from. KEEP commits to the live tree so the next candidate stacks on
top; REVERT does git reset --hard. Resume skips completed candidates by
idempotency key.
The phase exits when both arms are dry, when its budget is spent, or at the absolute per-phase cap.
IR-8 — --framework atom is single-node only
--framework atom (Magpie atom_mi*x.sh against
atom.entrypoints.openai_server) reaches full parity with sglang/vllm
EXCEPT multi-node: _apply_atom_auto_tighten in cli.py rejects
--nodes >= 2 with SystemExit(2) (atom upstream has no multi-node TP
wiring). No other flag is auto-flipped — kernel-agent, framework-agent,
profile / roofline / TraceLens all run on atom. The atom-specific
behaviors (configs, cold-start seed grid, source roots) are summarized
under Framework Selection below.
Retired modules and rules (do not re-introduce)
The live runtime uses protocol/action_surfaces.ACTION_CATALOGUE,
_grid_runner.py, and the unified specialist-informed explore flow. Do not
recreate the retired backends / params / validate_stack / scoring
modules, nor the actions/_meta/*.yaml catalogue and its ActionRegistry
loader, nor the vendor_kernel_config / operator_tuning /
deep_kernel_analysis actions (they never had an implementation).
Rules that look reasonable but break the current flow:
- No "source lever before configuration" rule in
prompts/orchestration.md— the two are arms of one phase, worked in parallel and ranked by what the bottleneck calls for. Upstream diffs land throughintegrate_patchwithpatch_source='upstream_pr'; there is no separateframework_agentaction for the LLM to propose or be denied. Use--no-framework-agentto skip the phase entirely. kernel_optsequencing is no longer gated by an explore-minimum check (theexplore_attempts_minimum_before_kernel_optrule was retired in loosen_plan P1_06). KERNEL_AGENT phase may proposekernel_optdirectly; thetrace_analyze → run_optimizationdata dependency (P2_11 handler-level check) and the reusablekernel_idvalidation still keep the inputs valid.
Setup
Two commands: Step 1 implements IR-2 (install gate), Step 2 launches. Both are idempotent; do not replicate them inside chat.
Credentials
The common single-gateway setup uses OPENAI_API_KEY and OPENAI_BASE_URL.
Split-gateway deployments may provide provider-specific ANTHROPIC_* /
OPENAI_* credentials instead. Shell-exported values win; $REPO_ROOT/.env
is loaded only to fill missing values. install.sh and the CLI preflight
enforce this internally; the launch recipes below enforce it by re-exporting a
snapshot of the caller's environment after sourcing .env, so a path variable
such as USER_DATA_PATH left in .env can never redirect a run to another
workspace. Never plain set -a; . .env — that inverts the precedence.
After Step 1, source the generated kernel-agent.env.sh in the same shell.
Step 1 — Install (one-time per pod / venv rebuild)
export REPO_ROOT="$(pwd -P)"   # repo root containing src/hyperloom/ + .env
bash "$REPO_ROOT/src/hyperloom/inference_optimizer/assets/install.sh"
. "${KERNEL_AGENT_ENV:-${USER_DATA_PATH:-/workspace/hyperloom}/runtime/kernel-agent.env.sh}"   # pod-local runtime env
src/hyperloom/inference_optimizer/assets/install.sh is the only install entrypoint for
full inference optimization. It installs the optimizer / Magpie / InferenceX
first, then chains to src/hyperloom/agents/kernel/scripts/install.sh for the kernel
optimization environment. src/hyperloom/agents/kernel/scripts/install.sh remains valid for
standalone kernel-agent debugging, but should not be the main entrypoint for a
full inference optimizer session.
The install phase always initializes the full Hyperloom runtime. Even if the
user later passes --no-kernel at runtime, the installer still prepares
kernel-agent / TraceLens / GEAK; --no-kernel only means
that this optimize run skips the kernel optimization phase.
install.sh installs everything in one shot (no --with-* flags to
remember). Direct steps in src/hyperloom/inference_optimizer/assets/install.sh:
| Component | Provided by |
|---|---|
inference_optimizer pkg + claude_agent_sdk extras (pip install -e .[test]) |
ensure_inference_optimizer |
Magpie (pip install "$MAGPIE_PACKAGE_SPEC"; default spec pins magpie-eval to $MAGPIE_REF) |
ensure_magpie |
INFERENCEX_PATH resolution (honours a pre-existing $INFERENCEX_PATH, else clones $INFERENCEX_REPO pinned to $INFERENCEX_REF into $INFERENCEX_DEFAULT_DIR = ${HYPERLOOM_CACHE_DIR:-$REPO_ROOT/.cache}/InferenceX@<sha>, reusing an existing checkout there on re-runs) |
ensure_inferencex |
INFERENCE_OPTIMIZER_FRAMEWORK_SOURCE_ROOTS appended to kernel-agent.env.sh |
_probe_framework_source_roots |
Chained from src/hyperloom/agents/kernel/scripts/install.sh (single chain at the end
of src/hyperloom/inference_optimizer/assets/install.sh):
| Component | Provided by |
|---|---|
ray==2.44.1 + click<8.3.0 |
pip |
| TraceLens public (editable install) | ensure_tracelens (pip install -e at $TRACELENS_ROOT; skills, patches, CLI, analysis orchestrator) |
| TraceLens-internal (editable install, optional) | ensure_tracelens (pip install -e at $TRACELENS_INTERNAL_ROOT only when set; mirrors read-only checkout to ${HYPERLOOM_ROOT}/TraceLens-internal; rehydration module). Unset => open-source-only. |
| GEAKv4 Claude Code workflow checkout + SDK deps | ensure_geak |
${KERNEL_AGENT_ENV:-${USER_DATA_PATH:-/workspace/hyperloom}/runtime/kernel-agent.env.sh} is
regenerated by install.sh and contains gateway URLs, auth aliases,
GEAK runtime variables, and InferenceX path. Source it (don't try to derive these by
hand). Generated env/config state is written to the pod-local runtime directory,
not back into a shared WekaFS source checkout.
Tool source fields (prompt → env, sandbox-only)
Prompt fields naming read-only source trees consumed by sandbox-side
install.sh / launcher. export <K>="<v>" in the launcher shell before
install.sh. These are sandbox-only — never ask the platform to bake them
into multi-node pod env; those pods have their own paths and do not consume
these.
| Prompt field | Env name | Consumer |
|---|---|---|
INFERENCEX_PATH: <path> |
$INFERENCEX_PATH |
src/hyperloom/inference_optimizer/assets/install.sh:ensure_inferencex |
TRACELENS_ROOT: <path> |
$TRACELENS_ROOT |
src/hyperloom/agents/kernel/scripts/install.sh:ensure_tracelens (public) |
TRACELENS_INTERNAL_ROOT: <path> (optional) |
$TRACELENS_INTERNAL_ROOT |
src/hyperloom/agents/kernel/scripts/install.sh:ensure_tracelens (internal; only when set) |
Multi-node escape hatch: if $TRACELENS_ROOT / $TRACELENS_INTERNAL_ROOT / $GEAK_ROOT /
$WORKSPACE_ROOT/Magpie / $INFERENCEX_PATH may move or differ across nodes,
rsync -a them into $SESSION_DIR/vendor/<name>/ and override the matching
env vars BEFORE running install.sh. Single-node WekaFS-mount setups (the
production default) need none of this — ensure_tracelens
already handles the read-only-source case.
Step 1.5 — Write the advisory model_arch profile (best-effort)
After the CLI creates the session directory, produce an advisory
architecture profile so the orchestration + specialist prompts carry richer
model context than the coarse --model-class tag. This is best-effort
and non-fatal: a missing / invalid file simply causes Hyperloom to omit
the section — it never blocks launch, never replaces --model-class
(still required), and is always subordinate to live TraceLens evidence
at runtime (it drives no deterministic gating — atom seed grid, framework
gap token, recipe key, and prompt label all stay on model_class).
Steps for the launching agent:
- Gallery lookup — fetch the LLM Architecture Gallery
(
https://sebastianraschka.com/llm-architecture-gallery/) and locate the card for the model being launched. Extract the schema fields below. - Fallback classify — if the model is not in the gallery, do a
lightweight classify from the model's local
config.json(decoder type, attention variant, expert counts, MTP, SWA window) and set"source": "config_classify". - Write the profile BEFORE launch and point
$HYPERLOOM_MODEL_ARCH_FILEat it. The CLI createssession_dirand reads the profile in the same process, so a file written to<session_dir>/model_arch.jsonafter the session dir appears always loses the race — the run seedsstate.model_arch={}and the profile never reaches any prompt. Write the JSON to a launcher-owned path instead and exportHYPERLOOM_MODEL_ARCH_FILE=<that path>in the shell that spawnsoptimize; the CLI copies it into<session_dir>/model_arch.jsonfor provenance. Use a session-unique filename —$USER_DATA_PATHis shared by concurrent sessions on WekaFS, so a fixed name races other launches. Includemodel_name(required for the stale-file guard). Set it to the clean model name (e.g.Qwen2.5-7B-Instruct); the guard normalizes launch forms — flat dirs, HF repo ids, and HF hub cachemodels--org--repo/snapshots/<hash>paths — so do NOT use the snapshot commit hash. All other fields are optional; renderers drop empty fields.
{
  "model_name": "DeepSeek-R1-0528",
  "source": "gallery",
  "decoder_type": "Sparse MoE",
  "attention": "MLA",
  "layer_mix": "61 MLA",
  "kv_cache_per_token": "68.6 KiB",
  "active_params": "37B active / 671B total",
  "num_experts": 256,
  "experts_per_tok": 8,
  "mtp": true,
  "swa_window": null,
  "norm": "RMSNorm",
  "notes": "DeepSeek V3-style: dense prefix + shared expert + MTP-1 path"
}
If you cannot determine the architecture, skip this step — do not write a placeholder file. Hyperloom degrades silently (WARNING in its own logs) when the file is absent, invalid, or stale.
Step 2 — Launch
Multi-node (nodes >= 2): multi_node/SKILL.md.
python3 -m hyperloom.inference_optimizer.cli optimize \
  --model "$MODEL_PATH" \
  --framework vllm \           # sglang (default) / vllm / atom / xdit / custom
  --gpu-type MI300X \          # or omit for rocm-smi auto-detect
  --model-class moe_mla \      # dense / moe_mla / moe_swa / moe_mla_nsa; categorical key for atom seed grid + framework gap token + recipe key + prompt label
  --isl 512 --osl 512 \        # workload shape — pass whatever the prompt states; omitting them uses defaults ISL=1024/OSL=1024
  --conc 64 \                  # client concurrency — pass the prompt's value; default 64
  --tp 1 --ep 1 \              # parallelism — pass the prompt's TP/EP; defaults 1/1
  --precision bf16 \           # match the checkpoint (bf16 default); use fp8 for an FP8 checkpoint
  --max-hours 2 \
  --compare-against-gpu B200   # optional — when set, fetches real InferenceX reference; when unset, target_analysis still runs and writes a 'no_target_gpu_configured' marker JSON
Caller responsibility (post-classify-removal): the in-loop setup /
classify actions were deleted; the SKILL caller is now expected to
supply session metadata directly via CLI flags. Any workload value the
operator states in the prompt (ISL, OSL, CONC, TP, EP, precision, budget, and
every --extra-env) MUST be forwarded as the matching CLI flag — these flags
are the only source of truth; an omitted flag silently falls back to its default
and the operator's stated value is lost:
| Surface | CLI flag | Notes |
|---|---|---|
| Model path | --model |
required |
| Framework | --framework |
sglang (default) / vllm / atom / xdit / custom — atom is single-node-only; xdit is scriptable diffusion (img/s, no serving server); custom is an operator-supplied workload and additionally requires --framework-path and --benchmark-scripts-dir (see below) |
| Custom source tree | --framework-path |
Required for --framework custom. The workload's own checkout; patches are authored against it. |
| Custom bench scripts | --benchmark-scripts-dir |
Required for --framework custom. Holds the entrypoint, looked up as custom_<gpu-type>.sh. Every knob it reads must be forwarded as --extra-env; the throughput unit is whatever its report declares. |
| GPU type | --gpu-type |
rocm-smi auto-detect when unset |
| Model class | --model-class |
categorical key for the deterministic consumers (atom seed grid, framework-agent gap search token, recipe key, prompt label); when unset, Coordinator boot infers and persists it from model metadata or model-path family keywords. For richer advisory model context see Step 1.5 (model_arch.json) |
| Input seq length | --isl |
Pass the prompt's ISL. Default 1024 when omitted. |
| Output seq length | --osl |
Pass the prompt's OSL. Default 1024 when omitted. |
| Concurrency | --conc |
Pass the prompt's CONC (max in-flight requests). Default 64. SWEEP measures a ladder around it; --conc-sweep-concs overrides the workload's default ladder. |
| Tensor parallel | --tp |
Pass the prompt's TP. Default 1. |
| Expert parallel | --ep |
Pass the prompt's EP for MoE. Default 1. |
| Precision | --precision |
Match the checkpoint (bf16 default / fp8 / ...). Keep consistent with --quantize. |
| Budget | --max-hours |
Pass the prompt's time budget. Default 2.0. |
| Max model len | --max-model-len |
Optional; auto-derived from ISL+OSL+headroom when omitted. |
| External reference GPU | --compare-against-gpu |
Coordinator always hard-gates target_analysis to run first so $SESSION_DIR/target_analysis/target_baseline.json exists before baseline runs. When this flag is set the JSON carries the InferenceX reference (reason="ok"); when unset the JSON carries a structured reason="no_target_gpu_configured" marker. The report renders the "External baseline" section from this JSON in both cases (heading switches to "(not requested)" for the marker variant) |
| Quantization prelude | --quantize |
Optional. Natural-language quantization request. Runs the quantization-agent once before the loop and rewrites --model to the quantized model. See Step 2b. Never runs on a resume. |
| Env pins | --extra-env NAME=VALUE |
Repeatable; forward every one verbatim as its own flag (do not drop any or fold into the Environment: block). The CLI persists them in state.json and serializes them into $INFERENCE_OPTIMIZER_EXTRA_ENV; a dropped pin is lost silently — e.g. a missing SGLANG_USE_AITER=0 leaves the explore aiter-MoE filter blind. A --resume-from re-exports the persisted set, so re-pass them only to change the set. |
Step 2b — Optional quantization prelude (--quantize)
When the user asks to quantize the model before optimizing (e.g. "quantize
to FP8 then optimize", "run this in MX-FP4"), pass --quantize "<scheme prompt>"
to the same optimize command. This runs the quantization-agent once as a
prelude, before any baseline/session work: it drives AMD Quark PTQ from the
prompt, then rewrites --model to the exported quantized model so the entire
optimization loop runs on the quantized model.
python3 -m hyperloom.inference_optimizer.cli optimize \
  --model "$MODEL_PATH" \
  --framework vllm \
  --quantize "fp8 global scheme, fp8 kv_cache, exclude lm_head; accept up to 5% relative eval gap" \
  --max-hours 2
- The
--quantizetext is the quantization request only (scheme / kv-cache / excluded layers / acceptable eval gap). Do not repeat the model path or export dir — the adapter folds--model+ a per-model export dir under the workspace root (<workspace_root>/quantization/<model>/quantized) into the prompt automatically. - Structured path for UI/backends: instead of free text, pass
--quantize-scheme <enum>(one ofnone/fp8/ptpc_fp8/mxfp4/mxfp4_fp8);mxfp4/mxfp4_fp8are MI355X-only. It resolves to a curated prompt internally (src/hyperloom/orchestrator/phases/quantization_schemes.py).noneor omit = no quantization. Free-text--quantizetakes priority when both given. - Keep
--precisionconsistent with the quantization. When a quantization scheme is requested, also set--precision/PRECISIONto that scheme (e.g.--quantize-scheme fp8→--precision fp8). Otherwise the benchmark configs, display names, and the optimization report carry the stale operator-supplied precision label (e.g.fp8/bf16) and mislabel an actually-quantized model. Never leave a conflicting precision when quantizing. - Behavior: one-shot, never runs on a resume. On a failed/unusable
quantization the run hard-stops (
SystemExit(3)) — it never silently optimizes the un-quantized source after an explicit--quantize. The one exception is a pre-flight scheme/GPU mismatch via--quantize-scheme(e.g.mxfp4on a non-MI355X target): this is skipped (not a hard stop) and continues on the un-quantized model, emitting aQUANTIZATION_SKIPPED:line on stdout and setting$HYPERLOOM_QUANTIZATION_SKIPPEDso the caller can detect it. - Prerequisites (in addition to the normal Setup):
$QUARK_ROOTmust point at a Quark checkout containing.claude/skills/quark-torch-*, and the installedamd-quarkpackage version must match that checkout (install editable from$QUARK_ROOTto keep them consistent). Claude SDK auth is the sameANTHROPIC_*env the rest of the loop uses. - After it finishes, the
Quantization prelude: model -> <dir>line on stdout shows the quantized model path that the rest of the run will use; include it in status reports.
A user request to optimize a model is approval to run Step 1 on a fresh node; do not stop for an extra confirmation. After IR-2, smoke-test the CLI:
export HYPERLOOM_KERNEL_AGENT_ROOT="$REPO_ROOT/src/hyperloom/agents/kernel"
export KERNEL_AGENT_ROOT="$HYPERLOOM_KERNEL_AGENT_ROOT"
export WORKSPACE_PATH="${WORKSPACE_PATH:-/workspace}"
# TRACELENS_ROOT: leave unset to let install.sh clone AMD-AGI/TraceLens
# to ${HYPERLOOM_CACHE_DIR:-$REPO_ROOT/.cache}/TraceLens@<sha> and pin it
# to a fixed SHA. Only export it as an operator override to point at a
# pre-existing checkout you maintain; this skips both the clone and the
# SHA pin.
# export TRACELENS_ROOT=/path/to/your/TraceLens
# Optional TraceLens-internal checkout; export only to enable it (open-source-only if unset):
# export TRACELENS_INTERNAL_ROOT=/workspace/TraceLens-internal

export PYTHON="${PYTHON:-$(command -v python3)}"
export PATH="$(dirname "$PYTHON"):/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin:${PATH:-}"

bash "$REPO_ROOT/src/hyperloom/inference_optimizer/assets/install.sh"
. "${KERNEL_AGENT_ENV:-${USER_DATA_PATH:-/workspace/hyperloom}/runtime/kernel-agent.env.sh}"
"$PYTHON" -m hyperloom.inference_optimizer.cli --help
Quirks: with set -u, assign dependent vars on separate lines (chained
export A=... B=$A can fail with unbound variable). The installer
leaves a live Ray head; ray status must succeed because trace_analyze
submits tasks with num_gpus>=1 — never restart Ray with --num-gpus=0.
_preflight() runs every launch as the in-loop counterpart of IR-2 and
owns the things the launcher must NOT do by hand: re-export auth
aliases (LLM) from OPENAI_API_KEY,
auto-pip install the SDKs / ray / Magpie /
InferenceX, ROCm hygiene, --gpu-type auto-detect, and it emits the
canonical Preflight diagnostics: block (paste verbatim into status
reports). Two checks abort the run on failure: the model gate
(probed against `<OPENAI_BASE_
…(truncated)